文字列が数字のみで成り立っているか調べる
問題
[10/30/2012] Challenge #109 [Easy] Digits Check : dailyprogrammer
概要
与えられた文字列が数字のみで成り立っていればTrue、そうでなければFalseを返す関数を書く。
たとえば小数点(.)を含むものはFalseを返す。入力
入力:数字のみを含むか含まない文字列。空でない。
出力:TrueまたはFalse例
"123"はTrue, "123.123"はFalse, "abc"はFalse
ノート
簡単すぎるので余裕のある人は文字列検索を高速化しましょう。以下の方法などいかがでしょ。
Knuth–Morris–Pratt algorithm - Wikipedia, the free encyclopedia
クヌース-モリス-プラット法 - Wikipedia
解答
入力は空文字列チェックしなくていい。
def digits_check(s):
    return all(map(lambda x: x.isdigit(), s))

print digits_check("123")     # => True
print digits_check("123.123") # => False
print digits_check("abc")     # => False
KMP法は…やるとしたら別記事で。
パンデジタル数(Pandigital Number)を見つける
問題
Need help with a number theory problem(java) : learnprogramming
3桁の数に3桁の数を足して4桁の数にする式を考える。0〜9までの数字を一度ずつ使ってこの等式を表したとき、3つの数が最小になるような組み合わせはどれか。
http://programmingpraxis.com/2012/10/30/pandigital-numbers/
解答
def is_pandigital(a, b, c):
    p = "".join(map(str, [a, b, c]))
    return len(set(p)) == 10

def min_pandigital():
    for i in range(100, 1000):
        for j in range(i, 1000):
            k = i + j
            if is_pandigital(i, j, k):
                return (i, j, k)

print min_pandigital()
野球のボールカウント
オフラインリアルタイムどう書く第三回の参考問題 #どう書く #yhpg #勉強会 #Ruby - Qiita
問題
野球のボールカウント・アウトカウントの遷移を計算する。(得点・ランナー・イニング の計算は不要)
ただし、ストライク・ボール・ファウル・ヒット・ピッチャーフライしかない。
細かいルールは下記の通り:
- ストライクが3つになったらアウトが増え、ストライクとボールがゼロになる。
- ボールが4つになったらフォアボールになり、ストライクとボールがゼロになる。アウトは増えない。
- ヒットを打ったらストライクとボールがゼロになる。アウトは増えない。
- ピッチャーフライを打ったらストライクとボールがゼロになり、アウトが増える。
- アウトが3つになったら、アウト・ストライク・ボール全てゼロになる。
- ファウルの場合、もともとストライクが1以下の場合はストライクが増え、ストライクが2の場合には変化なし。
- 入力は "sbsfbhsshssbbffbbssbs" のように、ひとつながりの文字列として与えられる。
- s, b, f, h, p がそれぞれ ストライク、ボール、ファウル、ヒット、ピッチャーフライ を意味する。
- 出力は、アウト・ストライク・ボールの順にカウントをつなげたものをコンマで区切る。例を参照。
- 不正入力には対処しなくてよい。
- 最終回を超えることも考慮しなくてよい。
解答
def ballcount(seq):
    hist = []
    o, s, b = (0, 0, 0)
    for act in seq:
        if act == "s": # ストライク
            s += 1
            if s == 3: # スリーストライク
                s = 0
                o += 1
        elif act == "b": # ボール
            b += 1
            if b == 4: # フォアボール
                s = b = 0
        elif act == "h": # ヒット
            s = b = 0
        elif act == "p": # ピッチャーフライ
            s = b = 0
            o += 1
        elif act == "f" and s <= 1: # ファウル
            s += 1

        if o == 3: # スリーアウト
            o = s = b = 0

        hist.append("".join(map(str, [o, s, b])))
    return ",".join(hist)
やり方は
オフラインリアルタイムどう書く第三回の参考問題解答(Ruby) #どう書く #Ruby #勉強会 - Qiita
と同じ。そんなにてらった書き方をしてもしょうがない。
テスト
import nose
from nose.tools import eq_

def test_ballcount():
    eq_(ballcount('s'), '010')
    eq_(ballcount('sss'), '010,020,100')
    eq_(ballcount('bbbb'), '001,002,003,000')
    eq_(ballcount('ssbbbb'), '010,020,021,022,023,000')
    eq_(ballcount('hsbhfhbh'), '000,010,011,000,010,000,001,000')
    eq_(ballcount('psbpfpbp'), '100,110,111,200,210,000,001,100')
    eq_(ballcount('ppp'), '100,200,000')
    eq_(ballcount('ffffs'), '010,020,020,020,100')
    eq_(ballcount('ssspfffs'), '010,020,100,200,210,220,220,000')
    eq_(ballcount('bbbsfbppp'), '001,002,003,013,023,000,100,200,000')
    eq_(ballcount('sssbbbbsbhsbppp'), '010,020,100,101,102,103,100,110,111,100,110,111,200,000,100')
    eq_(ballcount('ssffpffssp'), '010,020,020,020,100,110,120,200,210,000')

if __name__ == "__main__":
    nose.main()
Pythonでリストをflattenする方法まとめ
参考
1段ネストしたリストをflattenする方法
2段以上ネストしたリストをflattenする方法
色々方法があるみたいなので書留め。
1段ネストしたリストをflattenするとは
つまり、
l = [[1,2,3],[4,5,6], [7], [8,9]]
を
[1,2,3,4,5,6,7,8,9]
にするということ。
reduceを使った方法
reduceを使ってリストを畳み込むことができる。
reduce(lambda x,y: x+y,l)
組込み関数を使ったほうが読みやすいでしょう。
from operator import add
reduce(add, l)
sumによるやり方
空のリストに要素を積んでいく。これはちょっと思いつかなかった。
sum(l, [])
ここまではreduceの動作に慣れ親しんでいれば容易に理解できる。
リスト内包表記
sumやreduceによる方法は遅いらしい。参考リンク先の説明によると中間結果を毎回すべてコピーしているからだそうだ。
リスト内包表記は無駄なリストを作らないので高速に動作する。
[item for sublist in l for item in sublist]
ただしこれは入れ子の内包表記なのでかなり読みづらい。
かといって2段ネストさせても面白くないし…
result = []
for sublist in l:
    for item in sublist:
        result.append(item)
extend
extendのほうが内包表記より速かったりする。
x = []
for s in l:
    x.extend(s)
extendメソッドをキャッシュしておくとさらに速くなる。
ex = [].extend
for s in l:
    ex(s)
itertools.chain
実はpython.orgにはitertoolsのレシピとしてflattenする方法が載っていたりする。
9.7. itertools ― 効率的なループ実行のためのイテレータ生成関数 ― Python 2.7ja1 documentation
しかもこれが一番速い。
from itertools import chain
list(chain.from_iterable(l))
StackOverFlowばかり見てないで本家ドキュメントを読みなさいというお告げが聞こえる。
1段ネストしたリストのflattenまとめ
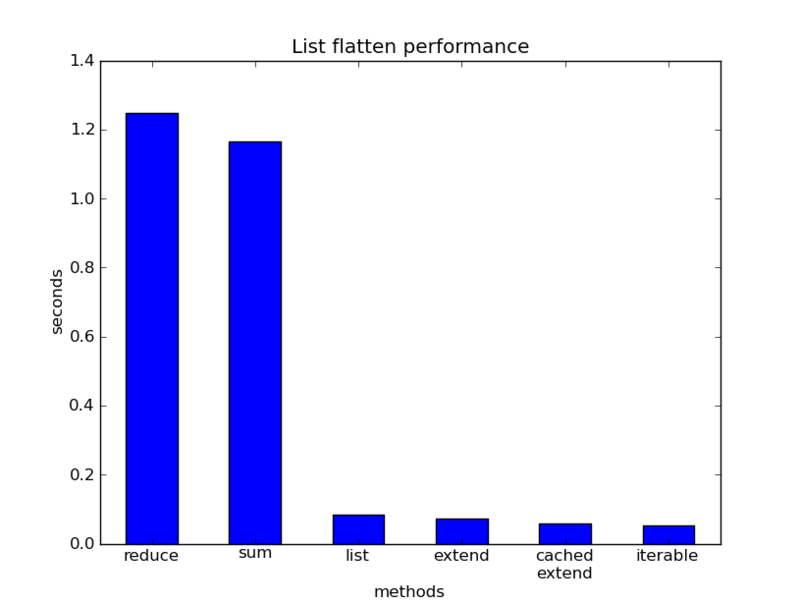
ここまで上で挙げた方法について、
[[1,2,3],[4,5,6], [7], [8,9]]**99
をTimer.timeit(1000)でflattenするのにかかった時間を計測し、グラフ化したものを載せる。右側ほど速い。
2段以上ネストしたリストのflatten
これまでのflattenでは多重ネストしたリストの場合内側のリストが残ってしまうという問題(というか仕様)があった。
flatten([[[1, 2, 3], [4, 5]], [6]]) # => [[1, 2, 3], [4, 5], 6]
また、
[1, [2, 3]]
のようなリストを平坦化しようとすると、1がIterableでないため、
TypeError: 'int' object is not iterable
となってしまう。これらの不都合な動作を抑制して、
flatten([[[1, 2, 3], [4, 5]], 6]) # => [1, 2, 3, 4, 5, 6]
と動作するflatten関数がほしい。
再帰による実装
任意の深さのリストをトラバースするとなると再帰による方法が自然に思える。
しかしflatten呼び出しの条件はどのように考えたら良いだろうか。
抽象基底クラスを用いて変数がIterableであるかどうかを判断し、その結果によって処理を振り分けるのが良いだろう。
isinstance(element, collections.Iterable)
抽象基底クラスが何であるか、なぜcollection.Iterableなのかは以下を参照。
ところで、文字列もIterableであるがこれは再帰されては困るので弾いておこう。
isinstance(element, collections.Iterable) and not isinstance(element, basestring)
これで再帰する条件は分かったのでflattenは実装できるだろう。
def flatten(nested_list):
    result = []
    for element in nested_list:
        if isinstance(element, collections.Iterable) and not isinstance(element, basestring):
            result.extend(flatten(element))
        else:
            result.append(element)
    return result
ジェネレータを使えばより効率良く実行できるだろうか。
def flatten_gen(l):
    for el in l:
        if isinstance(el, collections.Iterable) and not isinstance(el, basestring):
            for sub in flatten_gen(el):
                yield sub
        else:
            yield el
再帰なしの実装
さて、単純な再帰を使った実装では呼び出しの深さに限界が存在する。
l = []
for i in range(1000):
    l = [l, i]
flatten(l)
# => Runtime Error: maximum recursion depth exceeded
たいていの場合、再帰による実装はループとスタックを使った実装に置き換えることができる。
def flatten_loop(l):
    i = 0
    while i < len(l):
        while isinstance(l[i], collections.Iterable):
            if not l[i]:
                l.pop(i)
                i -= 1
                break
            else:
                l[i:i + 1] = l[i]
        i += 1
    return l
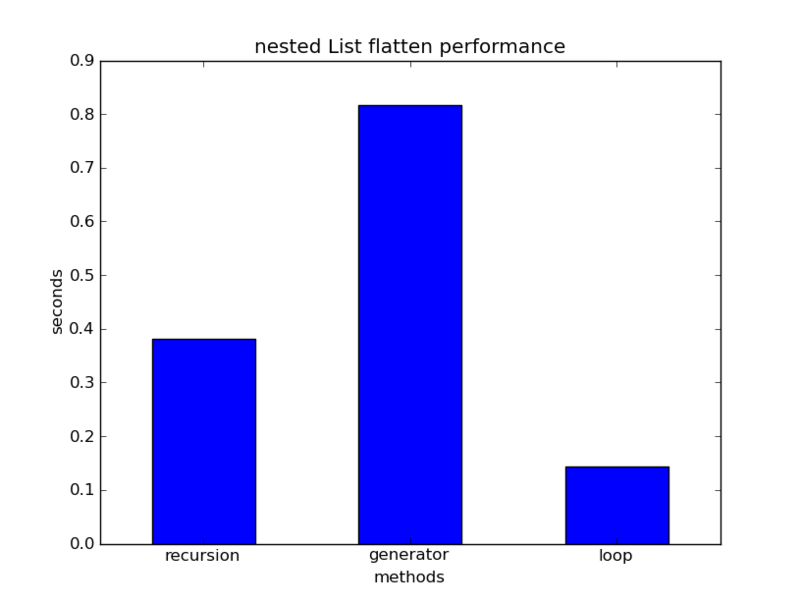
こいつはどんなに深くネストしていてもリストのサイズが許す限り平坦化を行うことができる。
単語の異なる文字の数[9/30/2012] Challenge #102 [intermediate] (n-character-set strings) : dailyprogrammer
[9/30/2012] Challenge #102 [intermediate] (n-character-set strings) : dailyprogrammer
問題
単語sと数nを受け取り、単語の異なる文字の数がn以下の時Trueそれ以外の場合False返す関数。
解答
def ncset(s, n):
    return len(set(s)) <= n

if __name__ == "__main__":
    words = open("enable1.txt").read().split()
    print len(filter(lambda x: ncset(x, 4), words))
setを使うと簡単すぎて困る。他言語でもHashつかってサイズ取るとか、ソートして配列走査するなどやりようは何通りかあると思う。
余りを取るだけの簡単な問題[10/18/2012] Challenge #104 [Easy] (Powerplant Simulation) : dailyprogrammer
問題
[10/18/2012] Challenge #104 [Easy] (Powerplant Simulation) : dailyprogrammer
日数を取り、3, 14, 100の倍数日ごとに停止する発電所の稼働日数を返す関数を作る。
解答
def plant_online_days(day):
    online_day = 0
    for i in range(1, day+1):
        if i % 3 and i % 14 and i % 100:
            online_day += 1
    return online_day
テトリスの揃った列を消す - Bit Tetris
解答
zip(*list)が便利すぎる。
def bit_tetris(notation):
    xbits = notation.split("-")
    bbits = map(lambda x: bin(int(x, 16))[2:].zfill(8), xbits)
    lanes = map(lambda x: "".join(x), zip(*bbits))
    newl = filter(lambda a: any(map(lambda b: int(b)!=1, a)), lanes)
    for i in range(len(lanes) - len(newl)):
        newl.insert(0, "0"*len(newl[0]))
    return "-".join(map(lambda x: hex(int("".join(x), 2))[2:].rjust(2, "0"), zip(*newl)))
テスト
import nose
from nose.tools import eq_

def test_bit_tetris():
    eq_(bit_tetris('ff-2f-23-f3-77-7f-3b'), '1f-03-00-1c-0d-0f-06')
    eq_(bit_tetris('01'), '00')
    eq_(bit_tetris('00'), '00')
    eq_(bit_tetris('7a-4e'), '0c-02')
    eq_(bit_tetris('56-b6'), '08-14')
    eq_(bit_tetris('12-12-12'), '00-00-00')
    eq_(bit_tetris('de-ff-7b'), '0a-0f-05')
    eq_(bit_tetris('95-be-d0'), '05-1e-20')
    eq_(bit_tetris('7c-b0-bb'), '1c-20-2b')
    eq_(bit_tetris('7a-b6-31-6a'), '3a-56-11-2a')
    eq_(bit_tetris('32-0e-23-82'), '18-06-11-40')
    eq_(bit_tetris('ff-7f-bf-df-ef'), '0f-07-0b-0d-0e')
    eq_(bit_tetris('75-df-dc-6e-42'), '35-5f-5c-2e-02')
    eq_(bit_tetris('62-51-ef-c7-f8'), '22-11-6f-47-78')
    eq_(bit_tetris('0c-47-8e-dd-5d-17'), '04-23-46-6d-2d-0b')
    eq_(bit_tetris('aa-58-5b-6d-9f-1f'), '52-28-2b-35-4f-0f')
    eq_(bit_tetris('ff-55-d5-75-5d-57'), '0f-00-08-04-02-01')
    eq_(bit_tetris('fe-fd-fb-f7-ef-df-bf'), '7e-7d-7b-77-6f-5f-3f')
    eq_(bit_tetris('fd-fb-f7-ef-df-bf-7f'), '7e-7d-7b-77-6f-5f-3f')
    eq_(bit_tetris('d9-15-b5-d7-1b-9f-de'), '69-05-55-67-0b-4f-6e')
    eq_(bit_tetris('38-15-fd-50-10-96-ba'), '18-05-7d-20-00-46-5a')
    eq_(bit_tetris('fe-fd-fb-f7-ef-df-bf-7f'), 'fe-fd-fb-f7-ef-df-bf-7f')

if __name__ == "__main__":
    nose.main()
