複素数クラスを実装することによりScalaのコンセプトを説明する: Complex Numbers in Scalaを読んで
Complex Numbers in Scala | Stoyan Rachev's Blog
Java Code Geeksの記事 CC-BY-SA 3.0
複素数クラスの実装を通じてScalaの重要なコンセプトを説明している。説明する主な機能は以下のとおり。
逐一流れをなぞってるけど翻訳ではなく読書ノートという位置づけで一つよろしくお願いします(逃げ)。あと日本語割と砕けてる。
開始
最初の定義はすごくシンプルに。
class Complex(val re: Double, val im: Double)
これで全部。2つのDouble型を持つだけ。Scalaにおいてはこれらの値はpublic(デフォルト)で変更不可能(valキーワードによる)である。
インスタンスを作るとこうなる。
scala> val x = new Complex(1, 2)
x: Complex = Complex@1e2350a
(原文ではこれだけでもJavaより簡潔ですよねムフフみたいなことを言ってるけどスルー)
メソッドのオーバーライド
インスタンスの表現がわかりづらいので、複素数を表現する a+b*i みたいな表示になるようにしましょう。
x: Complex = Complex@1e2350a
これはtoStringメソッドをオーバライドすればいける。どこからオーバーライドしているのかって? Scalaでは、すべてのクラスはAnyクラスから派生しているのだ。
class Complex(val re: Double, val im: Double) {
  override def toString =
    re + (if (im < 0) "-" + -im else "+" + im) + "*i"
}
overrideキーワードは必須だ*1。これを省いた場合、うっかりオーバーライドしてしまう事故を防ぐためにScalaではコンパイルエラーを吐くようになっている。
じゃあインスタンスを作ってみましょう。
scala> val x = new Complex(1, 2)
x: Complex = 1.0+2.0*i
メソッド、演算子メソッド
複素数に加算を定義してみましょう。とりあえずJavaっぽくaddメソッドを追加してみましょうか。
class Complex(val re: Double, val im: Double) {
  def add(c: Complex) = new Complex(re + c.re, im + c.im)
  ...
}
こいつはJavaのメソッド呼び出しと同じようにできる。
scala> val x = new Complex(1, 2)
x: Complex = 1.0+2.0*i

scala> val y = new Complex(3, 4)
y: Complex = 3.0+4.0*i

scala> x.add(y)
res0: Complex = 4.0+6.0*i
ところでScalaではね、副作用のないメソッドは演算子の表記みたいにして*2呼び出すことができるんだよ!
scala> x add y
res1: Complex = 4.0+6.0*i
さらにさらに、実は演算子+もオーバライドすることができるんです。addなんていらなかったんだ! そう、Scalaならね!
class Complex(val re: Double, val im: Double) {
  def +(c: Complex) = new Complex(re + c.re, im + c.im)
  ...
}
よってxとyの和はシンプルに計算できるようになった。
scala> x + y
res2: Complex = 4.0+6.0*i
これを見て「あっ、C++の演算子オーバーロードだ、殺せ!」となったキミ、ちょっと待ってほしい。実はね、Scalaでは演算子に見えるものでもすべてメソッドなんだよ! これにより、伝統的なオーバーロード手法よりも一貫的で簡明な演算子記法の取り扱いが可能になっているから安心してほしい。
メソッドとコンストラクタをオーバーロードする
複素数クラスに第2引数(虚部)を与えなかった場合、それは虚部を持たない実数として解釈できるよね。あと実数は複素数に含まれるのだからこの2つの数の間の演算も定義したい。
Scalaではもちろんコンストラクタとメソッドをオーバーロードすることができる。第2引数を省略した場合、すなわちim=0のコンストラクタと、+メソッドをDouble型を受け入れるようにオーバーロードしてみよう。
class Complex(val re: Double, val im: Double) {
  def this(re: Double) = this(re, 0)
  ...
  def +(d: Double) = new Complex(re + d, im)
  ...
}
これで実部の計算についても仕様をカバーしたComplexクラスができた。
scala> val y = new Complex(2)
y: Complex = 2.0+0.0*i

scala> y + 2
res3: Complex = 4.0+0.0*i
オーバーロードの記述はJavaや他の言語と似通っているが、コンストラクタのオーバーロードについてはScalaではさらに強い制約が課されていることに気をつけよう。つまりすべてのオーバーロードされたコンストラクタは最終的にデフォルトコンストラクタ(クラスの頭で定義されたやつ)を呼び出す必要があるのだ。またデフォルトコンストラクタはスーパークラスのコンストラクタしか呼び出すことができない。
暗黙の型変換
ところで、上のコードではy + 2する代わりに2 + yをしようとするとエラーが出る。残念ながらScalaの単純な数値型の+メソッドはComplex型を受け入れてくれないからだ。これを解決するためにDoubleからComplexへの暗黙の型変換を定義することができる。
implicit def fromDouble(d: Double) = new Complex(d)
これでDoubleにComplexを足すことができるようになった。
scala> 2 + y
res4: Complex = 4.0+0.0*i
ところで、implicitを用いればこれ以上 + をオーバーロードせずとも加算が定義できるのである。
やった、暗黙の型変換最高や! これさえあれば演算子オーバーロードなんて必要なかったんや!
じっさい、Why Method Overloading Sucks in Scalaで説明されているように、演算子オーバーロードより暗黙の型変換を好む深遠な理由があるのだ。Complexクラスの最終版では、単純な型クラスからの暗黙の型変換が加えられている。
アクセス修飾子
privateとprotectedは普通に使える。
ここでは複素数の絶対値を計算するmodulusをprivateで定義してみよう。
import scala.math.{sqrt, pow}

class Complex(val re: Double, val im: Double) {
  private val modulus = sqrt(pow(re, 2) + pow(im, 2))
  ...
}
単項演算子
ではこのComplexクラスの利用者にインスタンスの絶対値を取れるようにするにはどうしたらよいのだろうか? 絶対値の取得はとても一般的な演算なので、短いナイスな演算子で呼び出せるようにしておきたいですね! というわけで、ここでは単項演算子で呼び出せたほうがいいだろう。ありがたいことに、Scalaではこのような演算子を定義する楽な方法が存在する。
class Complex(val re: Double, val im: Double) {
  private val modulus = sqrt(pow(re, 2) + pow(im, 2))
  ...
  def unary_! = modulus
  ...
}
すなわちunary_を頭につけたメソッドは単項演算子から呼び出せるのである。
scala> val y = new Complex(3, 4)
y: Complex = 3.0+4.0*i

scala> !y
res5: Double = 5.0
コンパニオンオブジェクト
Scalaでは、objectキーワードによって、シングルトンクラスとシングルトンインスタンスを同時に宣言することができる。また、objectで宣言したシングルトンと同名のクラスが同一ファイル内で宣言されている場合、そのシングルトンはクラスのコンパニオンオブジェクトとなる。コンパニオンオブジェクトはそのクラスと特別な関係を取り持ち、クラスのプライベートなフィールドやメソッドにアクセスできるようになる。
Scalaにはstaticキーワードが存在しない。それはScalaの開発者がstaticは真のオブジェクト指向にはそぐわないものだと考えたからだ。よって、コンパニオンオブジェクトは他の言語で言うところのstaticなメンバを置いておくところである。例えばファクトリメソッド、そして暗黙の型変換などがここに書き込まれまれる。Complexクラスのコンパニオンオブジェクトを定義してみよう。
object Complex {
  val i = new Complex(0, 1)
  def apply(re: Double, im: Double) = new Complex(re, im)
  def apply(re: Double) = new Complex(re)
  implicit def fromDouble(d: Double) = new Complex(d)
}
このコンパニオンオブジェクトは以下のメンバを持つ。
- 定数i。これは虚数単位。
- 2つのapplyメソッド。これはComplexインスタンスを生成するファクトリメソッドで、newする手間を省くものである。
- 暗黙の型変換fromDoubleは上で紹介したとおり。
コンパニオンオブジェクトのお陰で、オブジェクト指向であることを損なわずにスッキリ書けるようになりましたね!
scala> 2 + i + Complex(1, 2)
res6: Complex = 3.0+3.0*i
トレイト(Traits)
数学的には複素数は比較することができない。とは言っても、実用上絶対値によって順序関係を導入しておけば便利であろう。数値型の比較には<, <=, >, >=という4つの演算子を用いることができる。
一つの方法として、それぞれ4つのメソッドについて演算を定義することが考えられるだろう。ところで、Scalaにおいては<, <=, >, >=を一度に定義するある種の鋳型(boilerplate)が存在し、これをトレイトと呼んでいる。
トレイトは、オブジェクトの型をサポートするメソッドのシグネチャによって規定するという点で、Javaのinterfaceに似ている。しかし部分的な実装を許しているという点で異なっている。これはJava 8のdefault methodという機能に似通っている。Scalaにおいてはクラスは拡張することができ、あるいはmixin class compositionによって複数のトレイトをmix-inすることができる。
ここでは、OrderedトレイトをComplexクラスにmix-inしている。このトレイトは4つの比較演算子(<, <=, >, >=)の実装を提供しており、その全てがcompareメソッドを呼び出すようになっている。つまりすべての比較演算がcompareに集約されており、我々はcompareの実装さえ与えてやればよい。
class Complex(val re: Double, val im: Double)
  extends Ordered[Complex] {
  ...
  def compare(that: Complex) = !this compare !that
  ...
}
これで複素数の比較演算ができるようになった。
scala> Complex(1, 2) > Complex(3, 4)
res7: Boolean = false

scala> Complex(1, 2) < Complex(3, 4)
res8: Boolean = true
Case Classとパターンマッチング
ところでまだ思ったように動作しない演算子が残っている。等価演算子==である。
scala> Complex(1, 2) == Complex(1, 2)
res8: Boolean = false
こうなるのは==がデフォルトではequalsメソッドを呼び出して、参照の等価性を調べているからである。一つの方法はequalsをオーバーライドすることである。ただしこの場合hashCodeもオーバーライドしなければならない。実に面倒ですね!
なんと、Scalaではcase classを用いることによってこのような面倒を回避するためにことができるのです。case classはクラス宣言の頭にcaseキーワードを足すことで定義できる。これによって以下のような便利機能が自動的に追加されるんだ。
- 適切なequalsとhashCodeの実装*3
- applyファクトリメソッド付きのコンパニオンオブジェクト
- クラス変数は暗黙的にvalで宣言される
書き方。
case class Complex(re: Double, im: Double)
  ...
}
これで==は期待通りの動作をするようになる。
scala> i == Complex(0, 1)
res9: Boolean = true
ところで、case classの最も重要な機能はそれがパターンマッチの中で利用できるということだ。このことを知るために、以下のtoStringの実装を見てみよう。
  override def toString =
    this match{
      case Complex.i      => "i"
      case Complex(re, 0) => re.toString
      case Complex(0, im) => im.toString + "*i"
      case _              => asString
    }
  private def asString =
    re + (if (im < 0) "-" + -im else "+" + im) + "*i"
このコードはそれぞれのパターン(虚数単位i, 実数, 純虚数, そして複素数)に対してthisがマッチするようになっている。パターンマッチングはVisitorパターンの代替と考えられるが、短くて理解しやすく、複雑なオブジェクト階層に沿って処理を行う場合にその恩恵は計り知れないものになる。
仕上げ
import scala.math._

case class Complex(re: Double, im: Double) extends Ordered[Complex] {
  private val modulus = sqrt(pow(re, 2) + pow(im, 2))

  // コンストラクタ
  def this(re: Double) = this(re, 0)

  // 単項演算子
  def unary_+ = this
  def unary_- = new Complex(-re, -im)
  def unary_~ = new Complex(re, -im) // 複素共役
  def unary_! = modulus

  // 比較
  def compare(that: Complex) = !this compare !that

  // 算術演算
  def +(c: Complex) = new Complex(re + c.re, im + c.im)
  def -(c: Complex) = this + -c
  def *(c: Complex) =
    new Complex(re * c.re - im * c.im, im * c.re + re * c.im)
  def /(c: Complex) = {
    require(c.re != 0 || c.im != 0)
    val d = pow(c.re, 2) + pow(c.im, 2)
    new Complex((re * c.re + im * c.im) / d, (im * c.re - re * c.im) / d)
  }

  // 文字列表現
  override def toString() =
    this match {
      case Complex.i => "i"
      case Complex(re, 0) => re.toString
      case Complex(0, im) => im.toString + "*i"
      case _ => asString
    }
  private def asString =
    re + (if (im < 0) "-" + -im else "+" + im) + "*i"
}

object Complex {
  // 虚数単位
  val i = new Complex(0, 1)

  // ファクトリメソッド
  def apply(re: Double) = new Complex(re)

  // 暗黙の変換
  implicit def fromDouble(d: Double) = new Complex(d)
  implicit def fromFloat(f: Float) = new Complex(f)
  implicit def fromLong(l: Long) = new Complex(l)
  implicit def fromInt(i: Int) = new Complex(i)
  implicit def fromShort(s: Short) = new Complex(s)
}

import Complex._
この記事に対するreactionという人のコメント
Complexクラスの最終版コードについて2つ。
case class Complex(re: Double, im: Double = 0.0)
S-99: Ninety-Nine Scala Problems所感 リスト操作編
Prolog学習者のための99問の練習問題をScalaで解こうという企画。難易度は(*), (**), (***)の三段階で分けられている(Prolog向け難易度の引き写し)。
解のエレガントさ、効率性にも留意せよ、ただし最初は効率より明瞭性を重視しましょうとのこと。いくつかの問題はビルトイン関数で解けちゃったりします。
以下では私が問題に取り組む際に考えていたことをだらだら述べます。こちらには私の書いた解を載せますが全てではありません。答えはリンク先で見れます。
リスト処理(問題 P1-P28)
P1 リストの最後の要素を返す
scala> last(List(1, 1, 2, 3, 5, 8))
res0: Int = 8
答えをいきなり見てScalaの基本的な書き方を再確認。去年ちょっとかじった程度だったので文法はほとんど忘れていたのだった。
型変数の付け方
def last[A](ls: List[A]): A
パターンマッチの書き方
ls match{
  case x :: Nil  => x
  case x :: tail => last(tail)
  case _         => new throw NoSuchElementException
}
を思い出す。
コーナーケースcase _(要素が1つもない場合)についても留意した。
P2 リストの最後から2番目の要素を返す
scala> penultimate(List(1, 1, 2, 3, 5, 8))
res0: Int = 5
1問目からの類推でどのようにしたらいいのかはだいたい見当がつくのだが、それに見合った記法が思い出せない。
よってこれもいきなり答えを見た。以下の書き方を覚えておく。
case x :: y :: Nil => x
P3 リストからK番目の要素を取り出す
リストの最初の要素を添字0で表すとする。
scala> nth(2, List(1, 1, 2, 3, 5, 8))
res0: Int = 2
タプルでのパターンマッチは覚えていたのですぐパスできた。
P4 リストの長さを求める
この辺りになるとだんだん頭が回ってくるようになる。今更ながら単純再帰の型がわりと決まりきっていることを感得する。
  def length[A](ls: List[A]): Int = ls match{
    case Nil        => 0
    case h :: tail  => 1 + length(tail)
  }
P5 リストを反転させる
単純な再帰でやると計算量オーダーがになる。これはリストの末尾への結合にかかる時間がリストの要素数分であるせい。継続渡しで要素をリストの先頭に継ぎ足していく方式にすれば
でいけるでしょう。もっとも解答見るまで忘れてたけど。
P6 リストが回文になっているか判定する
P5のような問題の次に必ず出される問題ですね。
P7 入れ子になったリストを平坦化する
解答はflatMapを使っているのですが、『mapを適用したあとリストの入れ子を解消する操作』ってなんかずるいですよね。
最初に書いたコードはこんな感じ。
object Flat{
  def flatten(ls: List[_]): List[_] = ls match{
    case List()                           => List()
    case (xs : List[_]) :: (ys : List[_]) => flatten(xs) ::: flatten(ys)
    case x :: (xs : List[_])              => List(x) ::: flatten(xs)
  }
}
パターンマッチが微妙に混乱している。Flatten a list - Rosetta Codeを見るともっとすっきり書いて良い事が分かる。
P8 連続した同じ要素を一つにまとめる
scala> compress(List('a, 'a, 'a, 'a, 'b, 'c, 'c, 'a, 'a, 'd, 'e, 'e, 'e, 'e))
res0: List[Symbol] = List('a, 'b, 'c, 'a, 'd, 'e)
これはすぐに分からなかった。dropWhileを覚えていれば、という感じ。
P9 連続する同じ要素をリストにまとめる
scala> pack(List('a, 'a, 'a, 'a, 'b, 'c, 'c, 'a, 'a, 'd, 'e, 'e, 'e, 'e))
res0: List[List[Symbol]] = List(List('a, 'a, 'a, 'a), List('b), List('c, 'c), List('a, 'a), List('d), List('e, 'e, 'e, 'e))
spanの使い方を覚える。
  def pack[A](ls: List[A]): List[List[A]] = ls match{
    case Nil  => Nil
    case _    => {
      val (packed, next) = ls span { _ == ls.head }
      packed :: pack(next)
    }
  }
P10 リストのランレングス符号をとる(P9の関数を利用して)
P9の返り値の型がList[(Int, Symbol)]になっているだけ。P9にもたついたので自習するつもりで一から書いたらP13と重複していた。言われたことを素直にやらないとこうなる(´・ω・`)
P11 リストのランレングス符号をとる(長さ1の文字は(1, 'a)でなく'aとする。
Aか(Int, A)型を返したいのだからEitherにするとスッキリする。
P12 ランレングス符号化されたリストをデコードする
簡単。解答のList.makeは新しめのScalaではdeprecateなのでList.fillにしましょう。
P13 リストのランレングス符号をとる
直接実装せよといってもP9と大した差はない。ちょっといじるだけ。
P14 それぞれの要素を複製する
scala> duplicate(List('a, 'b, 'c, 'c, 'd))
res0: List[Symbol] = List('a, 'a, 'b, 'b, 'c, 'c, 'c, 'c, 'd, 'd)
ところでリンク先の解答はここでもflatMapを使ってるけどやはり教育的じゃないと思う。
  def duplicate[A](ls: List[A]): List[A] = ls match{
    case Nil        => Nil
    case h :: tail  => List.fill(2)(h) ::: duplicate(tail)
  }
P15 与えられた数字の回数だけそれぞれの要素を複製する
scala> duplicateN(3, List('a, 'b, 'c, 'c, 'd))
res0: List[Symbol] = List('a, 'a, 'a, 'b, 'b, 'b, 'c, 'c, 'c, 'c, 'c, 'c, 'd, 'd, 'd)
P14をちょっと変えるだけ。
P16 N番目ごとに1つ要素を落としたリストをつくる
ちょっと日本語がわかりづらいかもしれないけど下を見れば単純。
scala> drop(3, List('a, 'b, 'c, 'd, 'e, 'f, 'g, 'h, 'i, 'j, 'k))
res0: List[Symbol] = List('a, 'b, 'd, 'e, 'g, 'h, 'j, 'k)
この辺りから継続渡しを始める。
  def drop[A](n: Int, ls: List[A]): List[A] = {
    def dropR(n: Int, ls: List[A], pn: Int): List[A] = ls match{
      case Nil                      => Nil
      case h :: tail if pn % n == 0 => dropR(n, tail, pn+1)
      case h :: tail                => h :: dropR(n, tail, pn+1)
    }
    dropR(n, ls, 1)
  }
P17 リストを2つのリストに分割する
scala> split(3, List('a, 'b, 'c, 'd, 'e, 'f, 'g, 'h, 'i, 'j, 'k))
res0: (List[Symbol], List[Symbol]) = (List('a, 'b, 'c),List('d, 'e, 'f, 'g, 'h, 'i, 'j, 'k))
takeとdropでやるのが普通だしそれが一番関数的なんだけど頭を使うために継続渡しする。
  def split[A](n: Int, lists: List[A]): (List[A], List[A]) = {
    // ls: left lists, rs: right lists
    def splitR(n: Int, ls: List[A], rs: List[A]):(List[A], List[A]) =
      (n, rs) match{
        case (_, Nil)       => (ls.reverse, rs)
        case (0, rs)        => (ls.reverse, rs)
        case (n, h :: tail) => splitR(n - 1, h::ls, tail)
      }
    splitR(n, Nil, lists)
  }
P18 リストのiからk番目までの要素を抜き出す
一応0を最初の要素としていることに注意。
scala> slice(3, 7, List('a, 'b, 'c, 'd, 'e, 'f, 'g, 'h, 'i, 'j, 'k))
res0: List[Symbol] = List('d, 'e, 'f, 'g)
もうこれはtakeとdropで実装するのが自然だろうということで(妥協)車輪を再発明。
  def slice[A](i: Int, k: Int, ls: List[A]):List[A] = {
    def drop(i: Int)(ls: List[A]): List[A] = (i, ls) match{
      case (0, _)         => ls
      case (n, h :: tail) => drop(n-1)(tail)
    }
    def take(k: Int)(ls: List[A]): List[A] = (k, ls) match{
      case (0, _)         => Nil
      case (n, h :: tail) => h :: take(n-1)(tail)
    }
    take (k-i) (drop(i)(ls))
  }
P19 リストを回転させる。N番目以降の要素を一番左へ。
scala> rotate(3, List('a, 'b, 'c, 'd, 'e, 'f, 'g, 'h, 'i, 'j, 'k))
res0: List[Symbol] = List('d, 'e, 'f, 'g, 'h, 'i, 'j, 'k, 'a, 'b, 'c)

scala> rotate(-2, List('a, 'b, 'c, 'd, 'e, 'f, 'g, 'h, 'i, 'j, 'k))
res1: List[Symbol] = List('j, 'k, 'a, 'b, 'c, 'd, 'e, 'f, 'g, 'h, 'i)
はじめ負の入力に気づかずP17を流用して事足れりとしていた(なんという注意力散漫!)。
リストの長さで剰余をとったあと負の値に関する条件分岐をする。大したことはないけど今までの問題に比べると泥臭い作業。
P20 K番目の要素を削除したリストと削除した要素のタプル
scala> removeAt(1, List('a, 'b, 'c, 'd))
res0: (List[Symbol], Symbol) = (List('a, 'c, 'd),'b)
  def removeAt[A](k: Int, ls: List[A]): (List[A], A) = {
    def removeAtR(k: Int, ls: List[A], rs: List[A]):(List[A], A) = (k, rs) match {
      case (_, Nil)       => throw new NoSuchElementException
      case (0, h :: tail) => (ls.reverse ::: tail, h)
      case (k, h :: tail) => removeAtR(k-1, h :: ls, tail)
    }
    removeAtR(k, Nil, ls)
  }
P21 リストに対して与えられた位置に要素を挿入するメソッド
scala> insertAt('new, 1, List('a, 'b, 'c, 'd))
res0: List[Symbol] = List('a, 'new, 'b, 'c, 'd)
splitAtも使わずに。
  def insertAt[A](elem: A, n: Int, ls: List[A]): List[A] =
    (n, ls) match {
      case (0, _)          => elem :: ls
      case (n, h :: tail)  => h :: insertAt(elem, n-1, tail)
    }
P22 rangeの再発明
  def range(start: Int, end: Int): List[Int] = {
    def rangeR(num: Int, count: Int): List[Int] = count match {
      case 0 => List(num)
      case _ => num :: rangeR(num+1, count-1)
    }
    rangeR(start, end-start)
  }
P23 リストからランダムにN個の要素を選んだリスト
util.Randomを使ったことがなかったので答えを見た。再帰するごとに(new util.Random)していては高くつくのでここでも継続渡しする。
P24 1..Mの数字からN個の異なる数のリストを得る
P22, P23から簡単に作れる。
P25 与えられたリストからランダムな並びのリストを作る(シャッフリング)
P23から即座に、
  def randomPermute1[A](ls: List[A]): List[A] =
    randomSelect(ls.length, ls)
すればよいことはわかる。純粋関数的にシャッフルするためには色々あるらしい。
// Efficient purely functional algorithms for shuffling are a lot harder. One
// is described in http://okmij.org/ftp/Haskell/perfect-shuffle.txt using
// Haskell. Implementing it in Scala is left as an exercise for the reader.
P26 与えられたリストからN個の要素を選ぶ組み合わせのリスト(combination)
その要素を選ぶか/選ばないかで再帰した。要素が尽きたらNil、選ぶ個数が尽きたらそれまでに選んだリストを返す。
  def combinations[A](n: Int, ls: List[A]): List[List[A]] = {
    def csR(n: Int, rs: List[A], ls: List[A]): List[List[A]] = {
      (n, ls) match{
        case (0, _)         => List(rs.reverse)
        case (_, Nil)       => Nil
        case (n, h :: tail) => csR(n, rs, tail) ::: csR(n-1, h :: rs, tail)
      }
    }
    csR(n, Nil, ls).reverse
  }
P27 リストの互いに素なグループ分けを行う
基本的にP26の結果を利用する。
a)問題
9人のグループを2, 3, 4人に分ける組み合わせをすべて列挙する。
scala> group3(List("Aldo", "Beat", "Carla", "David", "Evi", "Flip", "Gary", "Hugo", "Ida"))
res0: List[List[List[String]]] = List(List(List(Aldo, Beat), List(Carla, David, Evi), List(Flip, Gary, Hugo, Ida)), ...
b)問題
与えられた任意のグループ分けで分ける組み合わせを列挙する。
scala> group(List(2, 2, 5), List("Aldo", "Beat", "Carla", "David", "Evi", "Flip", "Gary", "Hugo", "Ida"))
res0: List[List[List[String]]] = List(List(List(Aldo, Beat), List(Carla, David), List(Evi, Flip, Gary, Hugo, Ida)), ...
自力では解けなかった。とくにb)問題はまだちょっと頭の中で消化できていない。
P28 リストをサブリストの長さに応じてソートする
a)問題
リストを要素に含むリストがあるとする。その要素リストの長さに応じて昇順にソートする。
  def lsort[T](ls: List[List[T]]): List[List[T]] = {
    ls.sortBy(_.length)
  }
ここに来て組み込み関数を使うずるさ。
b)問題
リストの要素リストの長さの出現頻度に応じて昇順にソートする。
  def lsortFreq[T](ls: List[List[T]]): List[List[T]] = {
    val countmap = mutable.Map[Int, Int]()
    val lens = ls map {_.length}
    lens.foreach ((i) => {
        val count = countmap.getOrElse(i, 0)
        countmap.update(i, count+1)
      }
    )
    ls.sortBy(x => countmap(x.length))
  }
もうすぐIPython Notebookが流行る気がするので
不在通知票を貼っておく。というか日本語の情報に飢えているので誰か包括的な解説を書いてほしいです。なんかできることが多すぎて私の手には余る。
- MatplotlibのグラフやSympyの数式がインタラクティブ表示できる
- Markdown形式で文章を挿入できMathJaxも普通に使える
- 無駄にYouTubeや画像を埋め込む機能までついてる
- なんかしらんけどRubyやBashやRやOctaveも実行できるし(!)
- nbconvertを使えば、普通にブログ記事としてBloggerやOctopressに貼り付けられる
- nbviewer使えばgithub/gistにホストしたファイルを記事化できる
- SAGEの最新版にも取り入れられる予定?
ほかにもいろいろ、いろいろできることがあるみたいです*1。
利用例
『これなら分かる応用数学教室―最小二乗法からウェーブレットまで』の例題を解いてみました。他にもいろいろツバをつけたけど多少区切りがついたのはこれくらいなので、もっとIPython使いこなせるようになりたいですね。いやほんとにLife-Changingになると思いますよ。IPython Notebookのおかげで、ちょっとした計算のインプットとアウトプットが限りなく近いものになるという予感があります。
参考リンク
- An HTML Notebook IPython ― IPython 0.14.dev documentation
- A gallery of interesting IPython Notebooks · ipython/ipython Wiki
- IPython Notebook Viewer
- GitHub/Gistでipynbファイルのraw URLを入力すると記事化してくれる。
- Fernando Perez: Blogging with the IPython notebook
- 基本的な使い方はここがよくまとまっている。
- Blogging with IPython in Octopress - Pythonic Perambulations
- Octopressに貼り付ける方法。
- Fernando Perez: The IPython notebook: a historical retrospective
- 歴史的経緯
*1:将来的な見込みも含めて。IPython開発チームは最近Sloan Foundationから115万$のグラントを得てNotebookの開発に注力することを宣言している
ライフゲームの向こうがわへ
ゼロ・プレイヤー
初めてコンウェイのライフゲームで何時間か遊んでみた時、それは自然を模倣した素晴らしい創作物であり、運命のすべてがここに構築されているという印象を受けた。ライフゲームは私たちの世代にとってのMinecraftのようなものだった; エレガントで、2Dで、白黒、そしてゼロ・プレイヤー、ソーシャルじゃないバージョンのMinecraft。シンプルなルールから"命"のようなものが立ち上がる; カンバスの上のカオスと相互作用による自己複製構造が。ここ数年、私はライフゲームのヴァリエーションについて考えてきた。そしてこれからはそれらについて探求をしていきたいと考えている。
歩くロシア人形
このビデオで示されているように、ライフゲームは入れ子構造を取ることができる。それはライフゲームが無限階層の入れ子にすることができ、フラクタルライフゲームをも作ることができるということである。またそれはライフゲームを再帰的に実行することも可能であり、例えば最高階層の入れ子は最低階層の入れ子のセルと相互作用しているということ、言うなれば"世界を包むドロステ"のようなものである。これを可視化することは[ドロステの]グリッドを曲げてみてたときと同じくらい面白いものになるだろう。メタく言えば、ドロステチックな方法とは、ライフゲームを作るためにマインクラフトでやるというようなことだ。
離散から連続へ
ふつうライフゲームは離散的なセルを整数を用いて[表現した]グリッド上で実行される。しかしながら、離散的なブロックを浮動小数点を用いて連続的にすることによってより自然に似かよった結果を得ることができる。直感的に、これは離散的なライフゲームという古典的な方法と比べて、自然を[表現するための]ずっと高い自由度を(無限大かプランクスケールのグリッドほどではないが)持っていることがわかるだろう。ここで視点を自然における生物に移すと、このJamie Zawinskiの創りだした浮動小数点によるシミュレーションはこれに(このやり方では)驚くべきほど似かよっている。
量子ライフゲーム
私はライフゲームにおけるそれぞれのセルが量子ビットによってモデル化できないかどうか疑問に思い始めた。ここにいかにして3Dのセル・オートマトンが動作するか説明した素晴らしいページがある。Zawinskiの浮動小数点シミュレーションと量子の領域横断的にN次元*1の量子ライフゲームを視覚化してみるのも面白いかもしれない。
ライフゲームの印刷
ライフゲームの興味ある形を作るのには時間がかかる。Gollyというプログラムを使えば時間を節約することもできる。Tom Robinsonは2Dライフゲームの汎用的なテキスト&イメージプリンターを開発した。3Dのプリンターについては寡聞にして知らない。とはいえ、Paul Slocumは物理的に3Dライフゲームを印刷している。
勝手に翻訳。年初らしい意気込みに当てられてちょっといいなと思ったので。
Golly
ところで上の記事で紹介されているGollyは面白いですよ。
ダウンロードは以下のページから行うことができる。
多数のサンプルが同梱されているので、それを動かして眺めているだけでも楽しいですね!
でもここではもうひとつ上で紹介されていたTom Robinsonの汎用プリンタをつかって好きな文字を生成するライフゲームを作ってみよう。
Game of Life text and image generator generator | tlrobinson.net blog
tlrobinson/life-gen · GitHub
ちなみに実行にはRubyとRMagick(ImageMagick)を利用しているので注意。
テキストから作りたい場合は実行時に次のようなオプションを渡すようにする。
> ruby -s [text] [output]
画像を入力したい場合、
> ruby -i [imagePath] [output]
という感じで。
こうして作ってみたのが以下の動画。撮影の手際が悪くて申し訳ないけど、ちゃんと文字が生成されていますね。ちなみに録画にはamareccoを使ってみました。便利ですね! こんな素晴らしいソフトを作って下さった製作者様に感謝! とは言いつつちゃっかりロゴは消してありますけどね!
画像のライフゲーム化はWindows機へのrmagickのインストールがコケて心が折れたので割愛します。
いやーライフゲームって本当にいいものですね。ちなみにニコニコ動画のこのライフゲームシリーズはとてもためになるのでおすすめです!
*1:Intrinsically universal n-dimensional quantum cellular automata, Pablo Arrighi, Jonathan Grattage (pdf)
*2:訳注:よくわからない。この人のことかな?Max Atkin's homepage at Theoretical Physics, Oxford
Word ladder
問題文
[12/4/2012] Challenge #114 [Easy] Word ladder steps : dailyprogrammer
ワード・ラダーは、単語を一度に一文字だけ変更することによって生成される単語の順列のことである。例:
cold → cord → card → ward → warmこの問題では、四文字単語の辞書を用いて、一つの単語が与えられたさい、一度に一文字変更する操作によって作ることのできるすべての単語を列挙してください。
辞書(RAWを選んで保存):selected four-letter words - Pastebin.com
入力例:
puma出力例
duma
pima
puja
pula
pump
puna
pupa
上記リンクの辞書リストからは、bestはいくつの単語を作ることができるだろうか?
ボーナス問題1:ある単語は一度の操作で33個の別の単語を作ることができる。それは何か?
ボーナス問題2:3回以下の変更操作で、bestはいくつの単語を作ることができるだろうか。
解答
全探索でも(この問題サイズなら)そんなに時間はかからない。
def neighbor_words(target_word, dictionary):
    neighbor_words = []
    for word in dictionary:
        count = 0
        word_length = len(word)
        for i in range(word_length):
            if word[i] == target_word[i]:
                count += 1
        if count == word_length-1:
            neighbor_words.append(word)
    return neighbor_words

def neighbor_words_with_depth(target_word, dictionary, depth=3):
    words = set([target_word])
    for i in range(depth):
        w = []
        for word in words:
            w.extend(neighbor_words(word, dictionary))
        words.update(set(w))
    return words

def main():
    best = "best"
    with open("./raw.txt") as f:
        lines = f.readlines()
        words = [line.rstrip() for line in lines]
    # Problem
    print neighbor_words(best, words)
    # => ['bast', 'beat', 'beet', 'belt', 'bent', 'bust', 'gest', 'hest', 'jest', 'lest', 'nest', 'pest', 'rest', 'test', 'vest', 'west', 'zest']

    # Bonus1
    for word in words:
        n = len(neighbor_words(word, words))
        if n == 33:
            print word
    # => care

    #Bonus2
    print len(neighbor_words_with_depth(best, words, 3))
    # => 575

if __name__ == "__main__":
    main()
バイオインフォマティックス学習サイトROSALINDが面白い
生物情報科学版 Project Euler といったおもむき。
やり方は最初の問題を開いてみればわかるはず。問題IDはその分野の用語っぽかったり? としゃれこんでいる。
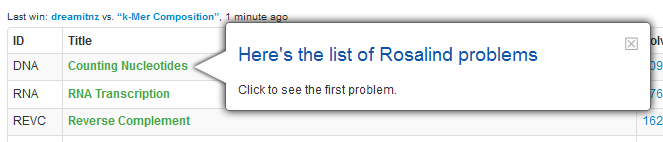
http://rosalind.info/problems/dna/問題ID:DNA ヌクレオチドの数え上げ
与えられたDNA文字列に含まれるそれぞれのヌクレオチドを数え上げる(文字列はアルファベットA,C,G,Tを含む。例:"ATGCTTCAGAAAGGTCTTACG")。
入力
長さ1000以下のDNA文字列
。
出力
サンプルデータ
AGCTTTTCATTCTGACTGCAACGGGCAATATGTCTCTGTGTGGATTAAAAAAAGAGTGTCTGATAGCAGCサンプルに対するアウトプット例
20 12 17 21
解答はページ下部のDownload Datasetから入力ファイルをダウンロードして行う(ファイル名の形式はrosalind_{問題IDの小文字}.txt)。
時間制限があり、ダウンロードボタンを押してから5分以内に答える必要がある。このへんはGoogle Code Jamっぽい?
制限時間に引っかからないためにもまず問題をしっかり吟味し、サンプルデータに対して正しい答えを出すコードを用意しておきましょう!
それぞれの問題にはゆるやかな関連性があり、簡単な問題を解くとそれよりも一段階難しい関連問題がレコメンドされるようになっている。
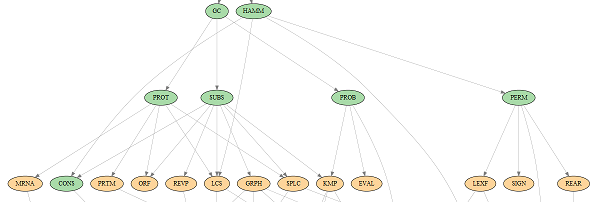
どうやらサイト自体が今年の7月ごろできたばかりのようで、まだ問題数も少ないが(66問, 2012.11.8現在)、利用者からの問題提出も受け付けているのでラインナップはこれからどんどん増えていくはず。
Pythonで問題を解く場合のTips
問題を解くときはもちろんどのようなプログラム言語を使っても構わないが、ROSALINDはPythonを推していたりする。
それぞれの問題については、いったん正答したあとは他の人の公開したソースを読むことができる。そして利用者もPythonで書いている人が多い印象がある。プログラミング初学者でROSALINDを始めてみようという人はこの機会にPythonを学んでみるのもよいかもしれない。
入力ファイル読み込みの小技
ファイルのオープンは普通次のように行う。
f = open("problem.txt")
text = f.read()
# ... テキストを処理する
f.close()
この方法だと、ファイルオブジェクトは不要になった時を見計らって明示的にcloseする必要がある。
これはwith文を使うと、ブロックを抜けるさい自動的に閉じてくれるようになる。
with open("problem.txt") as f:
    lines = f.readlines()
    # ... 処理 ...
改行のあるテキストファイルを読み込む
さて、ROSALINDの入力データには改行の含まれるものも存在する。問題は、入力データの改行フォーマットがWindowsのもの(CR CF)である場合があるということだ。この場合、UnixやMacintoshでは改行を含む文字列を扱うことができない。
Pythonでこの問題を回避するにはopenに"U"オプションを付けてやればよい。
with open("problem.txt", "rU") as f:
    # ... 処理 ...
標準の fopen() における mode の値に加えて、 'U' または 'rU' を使うことができます。 Python が全改行文字サポートを行っている (標準ではしています) 場合、ファイルがテキストファイルで開かれますが、行末文字として Unix における慣行である '\n' 、Macintosh における慣行である '\r' 、 Windows における慣行である '\r\n' のいずれを使うこともできます。これらの改行文字の外部表現はどれも、 Python プログラムからは '\n' に見えます。
http://www.python.jp/doc/release/library/functions.html#open
あるいはリスト内包の中でrstripをかけてもよい。たとえばつぎのようなcons.txtがあったとすると、
ATCCAGCT
GGGCAACT
ATGGATCT
AAGCAACC
TTGGAACT
ATGCCATT
ATGGCACT
これを読み込むために以下のように書く。
>>> open("./cons.txt", "r").readlines() # これだと改行コードが残る
['ATCCAGCT\n', 'GGGCAACT\n', 'ATGGATCT\n', 'AAGCAACC\n', 'TTGGAACT\n', 'ATGCCATT\n', 'ATGGCACT\n']
>>> [line.rstrip() for line in open("rosalind_cons.txt").readlines()]
['ATCCAGCT', 'GGGCAACT', 'ATGGATCT', 'AAGCAACC', 'TTGGAACT', 'ATGCCATT', 'ATGGCACT']
Uオプションは問題ID:CONS 『Consensus and Profiles』の解答欄でのやりとりを見て知った。
ROSALINDとはなんのことか?
サイトのAbout見ればわかりますが、DNAの二重らせん構造発見に貢献したロザリンド・フランクリンのことのようです。

ダークレディと呼ばれて 二重らせん発見とロザリンド・フランクリンの真実
- 作者: ブレンダ・マドックス,福岡伸一,鹿田昌美
- 出版社/メーカー: 化学同人
- 発売日: 2005/08/10
- メディア: 単行本
- 購入: 1人 クリック: 21回
- この商品を含むブログ (37件) を見る
ひとこと
サイトを知った経緯。redditをRSSで流し読んでたらたまたま目に入った。
I want to be better at solving algorithmic problems. : algorithms
Redditをスクレイピングする例題
[11/3/2012] Challenge #110 [Intermediate] Creepy Crawlies : dailyprogrammer
問題
問題文
Webは不気味なストーリーで溢れかえっています。Redditにおいては/r/nosleepに。あなたは熱烈な不眠愛好者ですから(我々は結局のところプログラマですからね)、それらの不気味なストーリーを簡単に読めるように一つのファイルに収集せざるを得ないでしょう! この問題では/r/nosleep上部の100ポストから投稿されたすべての文章をダウンロードして、シンプルなテキストファイルに放り込むWebクローラを作ってください。
入力 & 出力
- 入力:なし
- 出力形式:
- ファイルに保存するか標準出力する。フォーマットは以下のとおり:
- それぞれのストーリーはタイトルラインを引く。タイトルラインというのは[3つの等号記号, 投稿タイトル, 3つの等号記号]で引かれる。
- 例:"=== People are Scary! ==="
- それ以下の行にはストーリー本文を出力する。ただの平文でよい。HTMLフォーマットや箇条書き形式などなどは気にしなくてよい。
出力例
=== Can I use the bathroom? ===
Since tonight's Halloween, I couldn't... (your program should print the rest of the story, I omit that for example brevity)
=== She's a keeper. ===
I love this girl with all of my... (your program should print the rest of the story, I omit that for example brevity)
解答
RedditはRESTfulなjsonインターフェースを提供している。普通に解く場合(?)、Pythonはjsonエンコーダを標準搭載しているので適当なURLにアクセスしてごちゃごちゃすればいい。
またpraw(Python Reddit API Wrapper)を使うとひどく簡単になる。というかずるい。でもラッパーが提供されてるなら使わない手はない。
# -*- coding: utf-8 -*-
import praw

r = praw.Reddit("no sleep")
submissions = r.get_subreddit("nosleep").get_hot(limit=100)
for post in submissions:
    print "===%s===" % post.title.encode("utf-8")
    print post.selftext.encode("utf-8")
